



同名不同芯:价差10倍的光通信DSP,藏着两套截然不同的工程宿命(中)
发布时间:2026-10-09
上篇我们说到,数通 DSP 和相干 oDSP 价差近10 倍,根子在调制体制的分叉:一个只用光的强度维度;一个把相位、偏振全部调动起来。
但真正拉开天壤之别的,是算法内核。
两颗 DSP 最本质、最核心的区别
两颗 DSP 最本质、最核心的区别:数通 DSP 只做"修整容错",相干 oDSP 必须做"混沌重建"。
用一个不严格但直观的比喻:数通 DSP 是给轻微失焦的照片做锐化——你知道原图长什么样,只是细节糊了;相干 oDSP 是从一堆碎玻璃中还原整幅画——你甚至不知道画的是什么,必须靠物理规律反推。
数通 DSP:抚平信号损伤的"修图师"
相对相干长距链路,数通链路环境干净、干扰单一。信号在 PCB 走线、连接器、短距光纤中传输后,主要损伤就是高频衰减(波形"变胖")和时序抖动(时钟偏移)。DSP 不需要非常复杂的运算,只需要把失真波形修回标准形态。
它的工具箱很精简,但每一件都打磨到了极致:
• 均衡补偿(以线性为主):前馈均衡+判决反馈均衡,补偿高频衰减、消除码间干扰,800G及以上速率下已引入轻量级非线性辅助。这是数通 DSP 最重的工作负载,好在算法成熟、逻辑规模可控。
•时钟恢复(CDR):从畸变波形中抓取时序,保证收发同步。PAM4 信号有 4 个电平,时钟抖动容限比 NRZ 严苛得多,CDR 设计是核心难点之一。
•低开销硬判决 FEC:典型开销 <7%(如 RS(544,514)),在极低时延(通常 <20 ns 端到端)前提下完成轻量纠错。数通场景对时延极度敏感——AI 训练集群中,多 1 ns 延迟都可能影响万亿参数模型的收敛效率。
•TDECQ (发射机色散眼图闭合代价,Transmitter and Dispersion Eye Closure Quaternary)合规管控:发射端光信号质量的"体检指标",是 400G/800G PAM4 模块通过 IEEE 合规认证的核心门槛。
全程只管幅度、时域,不碰偏振、相位,无视长距色散。工具箱精简,但每一个工具都在功耗和面积的极限约束下反复优化——这才是数通 DSP 真正的工程难度。
相干 oDSP:重构信号秩序的"重型引擎"
长距光纤链路,相当于把信号扔进"搅拌机"——色散、偏振混叠、相位噪声、非线性失真同时作用,接收端看到的信号已经面目全非。
相干 oDSP 的工作,是从彻底搅乱的双偏振光场中还原原始数据。它的算法栈厚重了数个量级,且必须实时串行处理,任何一环掉链子,整条链路归零:
• 色度色散补偿:长距第一损伤源。100G 信号在 80 km 标准单模光纤中,色散导致的脉冲展宽可达数十个符号周期。oDSP 必须在电域完成纳秒级的全通滤波补偿。
• 偏振模色散补偿 + MIMO 解复用:光纤弯曲、应力变化会导致两路正交偏振信号互相串扰,且这个串扰是时变的(光纤随温度、振动实时变化)。必须用 2×2 MIMO 矩阵实时跟踪、解耦——数通体系完全无此需求。
• 载波相位恢复、频偏估计:发射激光器和本地振荡激光器的频率偏差、相位噪声必须实时追踪补偿。这是相干接收的"灵魂"——相位一旦失锁,星座图直接旋转崩溃。
• 概率星座整形(PCS,Probabilistic Constellation Shaping):根据信道条件动态优化星座点分布,让更多符号落在低噪声区域,逼近香农极限。这是近年相干技术最核心的进化之一。
• 高增益软判决 SD-FEC(Soft-Decision Forward Error Correction,软判决前向纠错):
10%–20% 高开销冗余,利用软信息(置信度)做迭代译码,净编码增益比硬判决高出 3–5 dB。代价是逻辑规模暴增、时延增加到微秒级——但长距传输几乎不在乎这几百纳秒,在乎零误码。
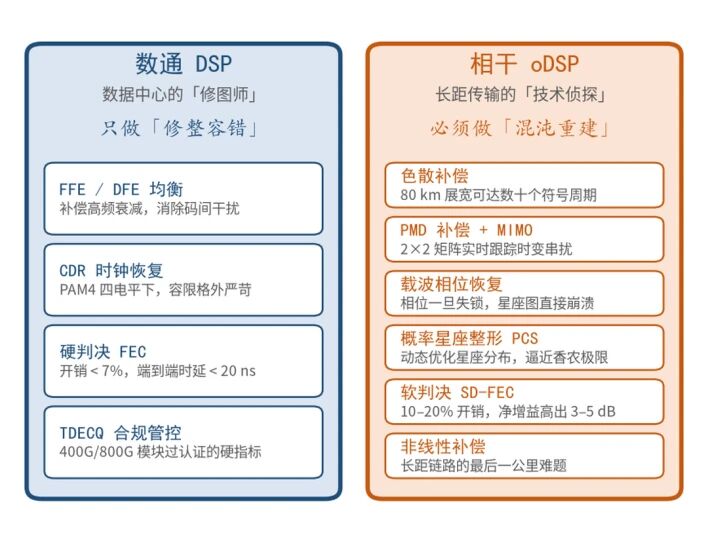
图1 · 两套算法工具箱:修图师与技术侦探
如果说数通 DSP 是微调瑕疵的修图师,相干 oDSP 就是还原真相的技术侦探——从一团混沌中抽丝剥茧,重建完整信号秩序。
硬件代价:算法复杂度最终都要落在硅片上
算法的复杂度从来不是纸上理论。最终都会实打实转化为芯片面积、功耗、成本——这是半导体行业最朴素的真理。
模拟前端:规格量级差相干传输需要同时解析双偏振 I、Q 四路正交信号,必须搭载 4 路高速ADC;而数通 PAM4 信号结构简单,对采样精度和速率要求低得多,硬件开销大幅缩减。仅 ADC/DAC 这一项,相干 oDSP 的硅片面积就是数通的 3–4 倍。
功耗水平:数倍直观差
同为主流 7 nm 工艺节点下,400G 数通 DSP 仅 4 W 左右,而相干 oDSP 高达 12–15 W。量产相干模块整机普遍 20–26 W——本质是海量并行运算单元、复杂算法逻辑门的堆叠。更关键的是,相干 oDSP 的功耗随波特率几乎线性增长,而数通 DSP 的功耗增长曲线相对平缓。
成本结构:规模效应差
相干 oDSP 研发门槛极高——单颗芯片设计验证投入数亿人民币,整个流片周期 18–24 个月,全球年出货仅数十万到百万量级,成本摊薄难度大。数通 DSP 遵循公开标准、千万级出货、极致规模化,成本被持续压到极致。一奢一俭,一专一通,最终在芯片层面拉出近十倍的价差。
一个常被忽视的细节:时延的"价值观差异"
数通DSP芯片处理时延通常控制在 20 ns 以内,因为 AI 训练集群中对时延极度敏感,多 1 ns 都可能影响模型收敛。而相干 oDSP 的大时延主要来自 SD-FEC 迭代译码,整体处理时延轻松达到几百纳秒至微秒级别;色散补偿本身引入时延很小——但长距传输多跑这几百公里,多等几百纳秒根本无所谓。
这不是"谁做得更好"的问题,而是"什么指标值得优化"的选择。 数通选时延,相干选增益。没有对错,只有取舍。
结语
一个在修图容错,一个在破案还原。同名同姓,内核天差地别。这背后没有谁高谁低——修图师不需要侦探的装备,侦探也用不上修图师的滤镜。算法是芯片的灵魂,而取舍,才是工程最朴素的本质,这正是工程世界最迷人的地方。下一篇,我们跳出芯片本身,看看两条赛道长出了怎样的产业生态,以及"去 DSP 化"和"相干下沉"正在如何重塑行业格局。
